
识别合金性能可能既昂贵又耗时。涉及合金的实验往往需要大量资源,而且合金性能的计算也会变得极为复杂,其性能配置似乎无穷无尽。
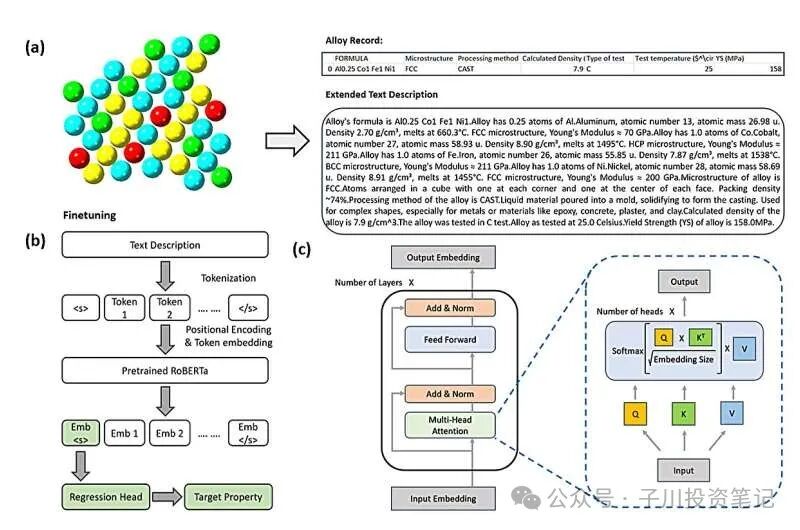
机械工程副教授巴拉蒂・法里马尼(Barati Fairmani)和他的团队专门设计了 AlloyBert,以减少识别合金性能通常所需的时间和成本。大多数语言学习模型要求用户以极其精确的措辞输入信息,这是一个耗时的过程。而将 AlloyBert 设计为基于 Transformer 的模型,用户的输入可以更加灵活。
“我们想要一个模型,它能轻松获取特定的物理性能,而不必过分担心我们拥有的信息以及它是否符合特定格式,” 材料科学与工程专业的硕士生阿克沙特・乔杜里(Akshat Chaudhari)说,“准确的信息和格式仍然很重要,但 AlloyBert 允许更高的灵活性。”
AlloyBert 的基础模型是 RoBERTa,这是一个已有的编码器。之所以使用 RoBERTa,是因为它的自注意力机制,该机制能让模型判断句子中特定单词的重要性。在 AlloyBert 的训练中融入了这种自注意力机制,使用了两个合金性能数据集,AlloyBert 对 RoBERTa 模型进行了微调。研究结果表明,Transformer 模型可以作为预测合金性能的有效工具。
目前,AlloyBert 存在两个偏差,团队希望进一步研究。AlloyBert 预测的准确性并不总是与输入的详细程度一致。团队原本预期向 AlloyBert 提供的信息越多,输出就会越准确。
然而,他们的实验表明,在某些情况下,输入最少的数据反而能得到最准确的输出。团队认为这可能是由于 AlloyBert 的训练仅限于两个数据集。
“在非常大的语料库上训练模型可能会得到更一致的结果,” 乔杜里指出。
第二个偏差是在研究团队采用两种训练策略时发现的,一种是先进行预训练然后微调模型,另一种方法只进行模型微调。团队假设采用预训练和微调相结合的方法会产生更准确的输出。在每个数据集中,这种情况有八分之一的概率发生。
虽然他们的假设基本得到了支持,但他们发现,在某些情况下,与一些包含更多信息的输入相比,仅对模型进行微调会产生更好的结果。团队预测这种偏差可能是因为他们的预训练使用了掩码语言模型(MLM),未来的研究可能会采用替代的预训练模型。
总体而言,这项研究和 AlloyBert 的开发带来了多种可能性。除了上述两个偏差外,AlloyBert 的代码可以进一步开发,以识别除合金之外的其他材料。法里马尼的团队还设想开发一个与 AlloyBert 相反操作的模型,即给定合金性能作为输入,然后分解出构成它的元素。
该研究结果发表在 arXiv 预印本服务器上,AlloyBert 的软件现已在 GitHub 上可供使用。
https://arxiv.org/abs/2403.19783
https://github.com/cakshat/AlloyBERT
~完~
附录:
一、DFT 在这篇文章中是指密度泛函理论(Density Functional Theory)。
- 基本原理
密度泛函理论是一种研究多电子体系电子结构的量子力学方法。它的基本思想是,体系的基态物理性质可以通过电子密度分布函数来唯一确定。简单来说,电子密度就像是一个 “指纹”,通过它可以了解系统的各种特性。 例如,在一个原子或分子中,电子是在原子核的吸引下运动的。DFT 通过求解电子密度来描述电子的行为,而不是像传统的量子力学方法那样直接求解多电子波函数(因为求解多电子波函数非常复杂,随着电子数目的增加,计算量呈指数增长)。 - 在材料科学中的应用(如合金研究)
在合金性能研究中,DFT 可以用于计算合金的各种物理性质。例如,它可以帮助确定合金的晶格结构、电子态密度等。 从原子层面看,合金是由不同种类的金属原子组成的,DFT 可以计算原子间的相互作用能,从而预测合金的稳定性。通过这种方式,可以了解合金在不同条件下(如不同温度、压力)是否会发生相变,这对于材料的设计和应用非常重要。 然而,正如文章中提到的,DFT 计算对于复杂合金来说可能非常耗时,因为它需要大量的计算资源来准确地求解电子密度等相关物理量。
二、MLM
掩码语言模型(Masked Language Model,MLM)是自然语言处理中的一种重要模型架构。
这种训练方式使得模型能够学习到文本中单词之间的语义和语法关系,从而增强对语言的理解和生成能力。像 BERT(Bidirectional Encoder Representations from Transformers)等模型就广泛采用了 MLM 技术进行预训练,通过大量的文本数据训练,模型可以捕捉到丰富的语言知识和语义信息,在后续的自然语言处理任务如文本分类、情感分析、问答系统等中表现出良好的性能。