李飞飞团队50美金复刻OpenAi推理模型,真相如何?
【标签】
子川投资笔记微信公众号:“新知”栏目,以人文视角关注AI、脑与认知、前沿科技,力图提供最新和最好的外刊文章中译、导读;“经典”栏目,持续更新“巴菲特致股东信”精译及评注系列;“维特根斯坦”哲学系列;“洞见”栏目:分享关于技术进步、AI哲学与伦理、投资哲学的深度思考。
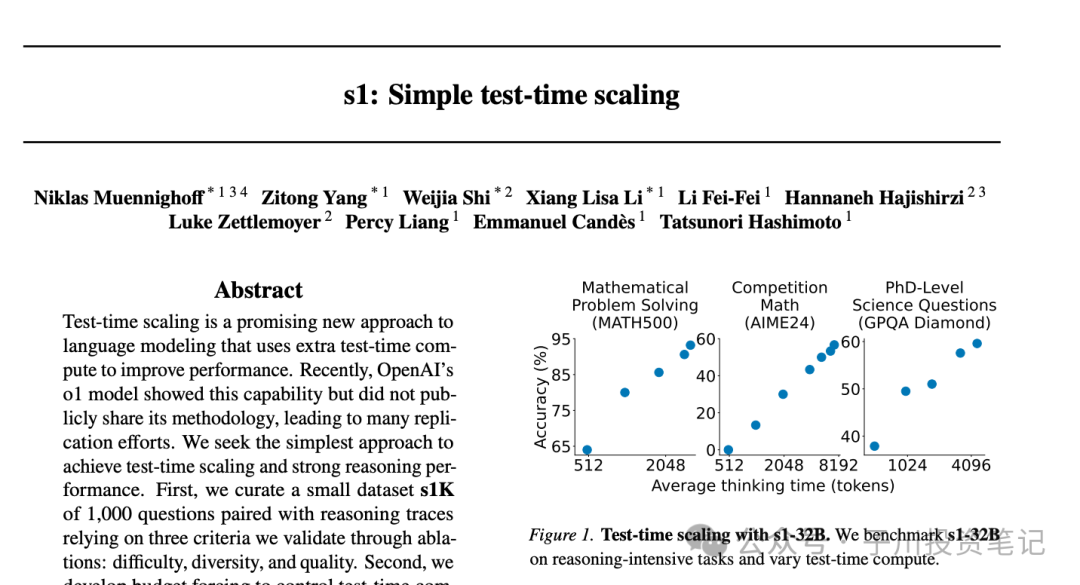
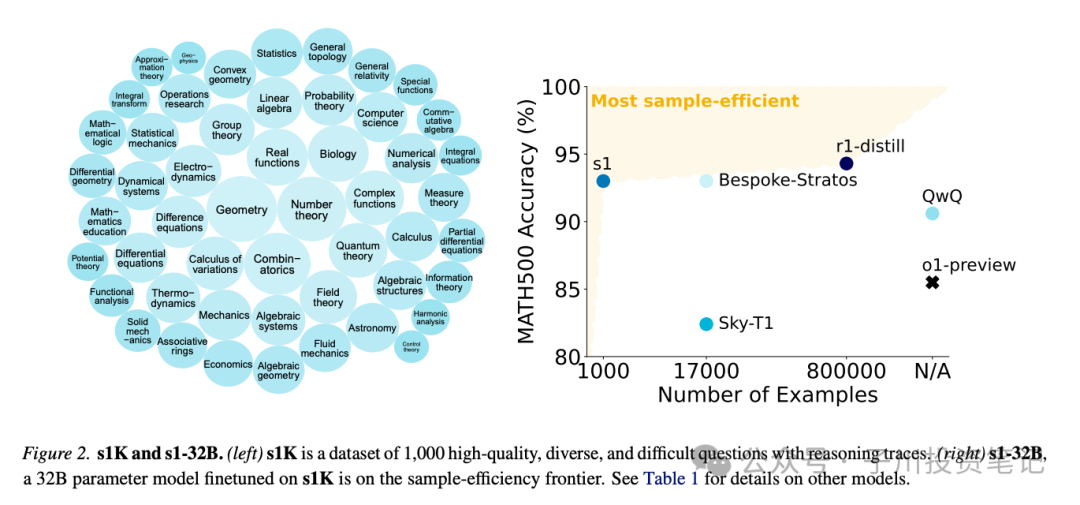
华裔科学家李飞飞,其团队在上周五发布了一项重要研究成果,仅用 50 美金就复制出与OpenAI O1-preview类似的推理模型-s1。OpenAI 此前在 O1 中展示了"测试时扩展(Test-time Scaling)"的新方法,通过在测试阶段增加计算资源来提升模型性能,但未公开实现细节。这个成果令人瞩目 - 在 MATH 和 AIME24 测试中,s1 的表现比 OpenAI 的 o1-preview 高出 27%。通过预算强制机制,还能将 AIME24 的成绩从 50% 提升到 57%。团队采用了一套高效的技术路线:选用阿里的 Qwen2.5-32B-Instruct 作为基础模型,通过蒸馏技术从谷歌的 Gemini 2.0 Flash Thinking Experimental 中提取推理能力。为确保训练质量,团队构建了包含 1000 个问题的数据集 s1K,每个问题都配有推理轨迹。这些问题经过难度、多样性和质量三个维度的严格筛选。训练采用监督式微调(SFT)方法,这比 DeepSeek 的大规模强化学习方案省钱得多,也比伯克利研究人员 450 美元的方案更实惠。团队还开发了创新的预算强制(budget forcing)机制,用两种方式控制模型思考:直接终止思考过程,或用"wait"指令延长思考时间。这种方法让模型能重新审视答案,往往能纠正错误的推理步骤。该研究组已经把相关模型、数据和代码上载 GitHub(https://github.com/simplescaling/s1)开源。这给预算有限的研究人员提供了希望 - 不用大把砸钱也能在 AI 领域进行创新。不过总结来看,真相是有用,但S1所用方法并非万能,虽然能以低成本复制现有 AI 模型的能力,解决算力成本问题;但S1 仍然依赖阿里模型基座和Gemini,无法创造出超越现有模型的新能力。大规模投资仍然是推动 AI 根本性创新的必要条件。
~完~
感谢阅读,麻烦点个👍和❤️,谢谢!
~End~